Google Cloud于2026年11月19日宣布Cloud Storage的object enrichments进入预览。该能力利用模型从存储对象中提取语境信息,并将结果写入对象自身的object context,而非要求客户另建一套元数据存储。
当前是预览服务,不能把所有文中提及的多模态能力都视为已经开放。
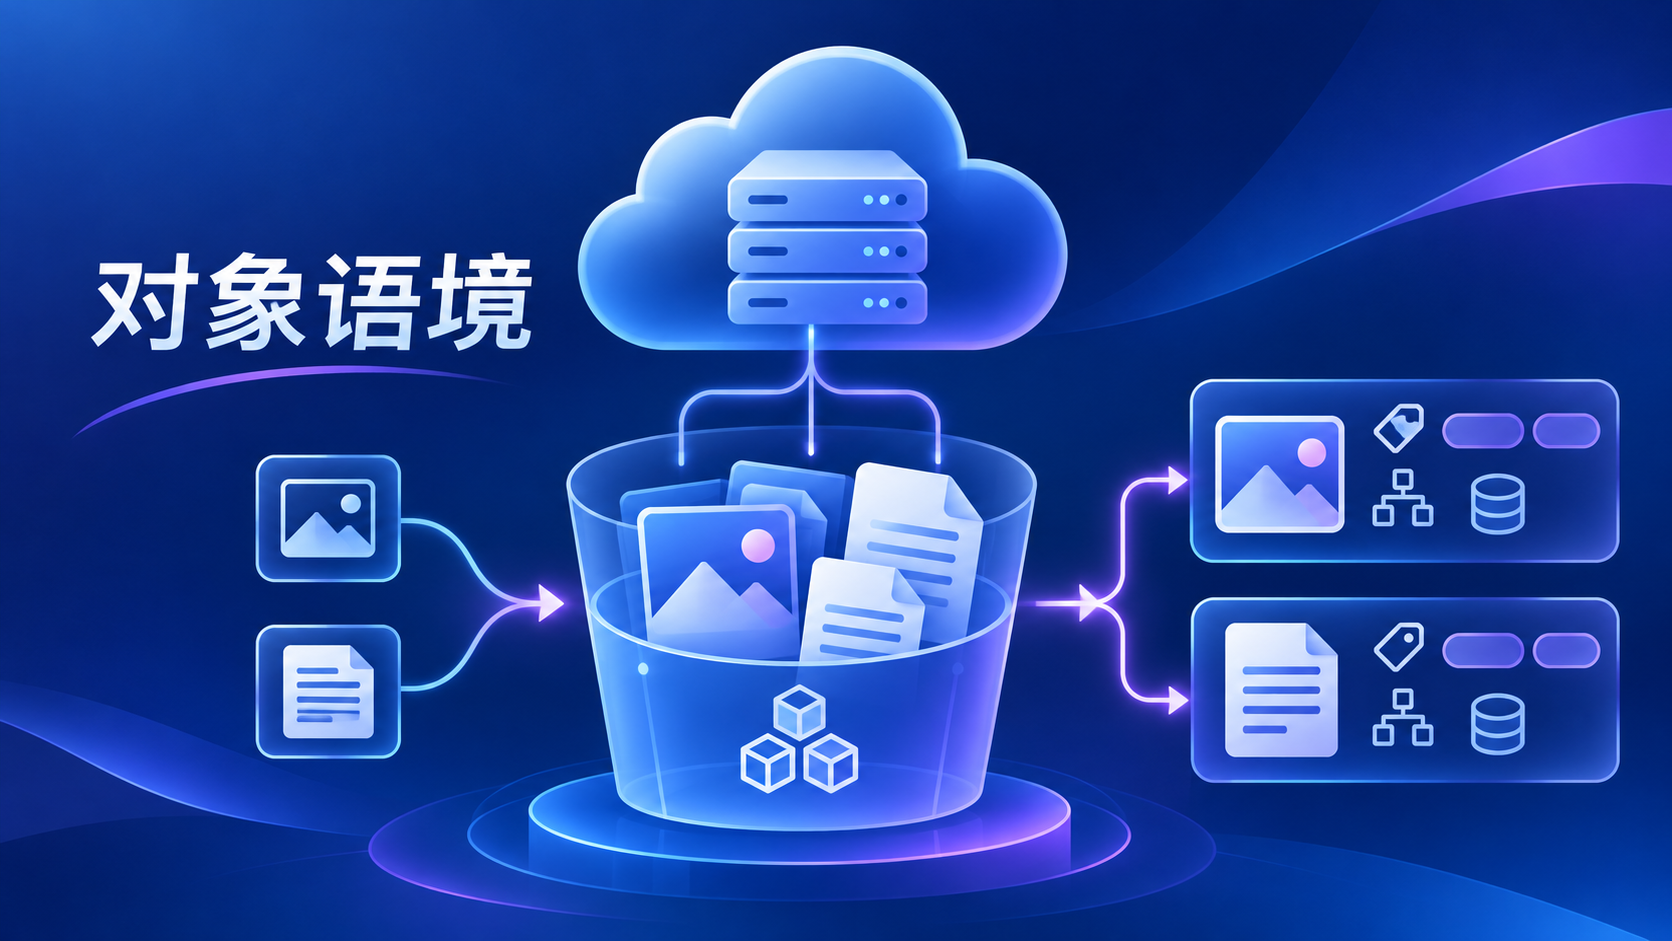
这项功能如何处理对象
用户选择待处理的存储桶和处理位置,指定模型并授予必要的IAM权限后,服务负责模型推理、结果解析、重试与限流。输出以结构化键值形式保存在对象上下文中。
授权范围应只覆盖需要提取的存储桶及必要操作。
预览阶段支持哪些模型
官方介绍了用于图像标注的模型,包括对象检测、图像标签等,以及PDF分类模型。博客称可从五个第一方Cloud Storage模型中选择。不同文件类型与输出字段应按实际模型说明确认。
涉及人脸或敏感内容时,应先核对数据处理与访问控制要求。
对象上下文带来什么变化
Google表示,object context与对象一同经历复制、移动及复制到其他位置,并在对象删除时被移除。IAM可分别控制语境信息的读取、添加、更新和删除。应用也可按上下文键值筛选对象。
把提取结果与原对象放在一起,仍须管理元数据读取权限。
如何接入数据分析
官方说明,可通过Storage Insights数据集把对象上下文用于BigQuery分析,再与结构化业务数据关联。适用场景包括媒体资产发现、内容审核和文档分类,但具体准确率需要用自身数据集评估。
博客提到的Gemini跨文本、音频和视频等更广泛提取能力需联系Google申请,不属于直接可用的预览功能。
采用前应核对哪些边界
团队应先用有限对象集验证分类质量、元数据字段、权限和费用,再决定是否扩大范围。官方把当前服务标为预览,并引导用户查看Cloud Storage定价与配置文档。
验收时同时检查对象上下文是否按预期写入、查询和随对象生命周期变化。