昨天凌晨 3 点,OpenAI 又做了一件很有意思的事情。
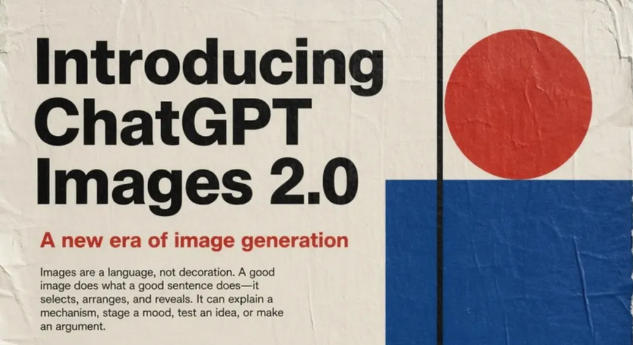
他们发布了 ChatGPT Images 2.0,但这次重点已经不是图像生成更好看,而是一个更明显的方向变化:
图像从生成工具,变成了表达系统。
如果你看了官方博客,其实会发现一句很关键的话:
图像是一种语言,而不是装饰。
这句话基本已经把这代模型的定位说清楚了。它不再只是根据提示生成图片,而是开始参与信息表达、结构组织,甚至可以承担一部分设计工作。
很多人第一反应还是:
这个是不是就是 DALL·E 的升级版?
但我实际用下来,它更像是:
👉 一个可以参与视觉设计过程的模型
这篇文章我会把免费使用方式、实际体验路径,以及适合的使用场景全部讲清楚。
一、ChatGPT Images 2.0 的核心能力变化
这一代模型的变化主要集中在可控性、表达能力和执行能力三个层面。
1. 指令遵循能力显著提升
Images 2.0 在复杂指令下的稳定性明显增强,尤其是在涉及多个约束条件时表现更好。
在实际测试中,可以明显感受到它能够同时处理以下内容:
- 构图结构
- 元素位置关系
- 风格约束
- 文本内容
相比上一代模型容易丢失细节的问题,这一代更接近完整执行任务,而不是部分完成。OpenAI 也强调,该模型可以更好地保留细节并准确渲染复杂元素,例如小文本、图标和界面组件 。
2. 文本渲染能力进入可用阶段
图像模型长期存在一个问题,即文字无法稳定生成,尤其是在非英文环境下表现更差。
Images 2.0 在这一点上有明显突破:
- 可以生成可读中文
- 支持日文、韩文等多语言
- 文本排版更自然
这一变化直接带来的结果是,很多图像可以不再依赖后期编辑,而是生成后即可使用。
3. 多图一致性生成能力
新模型支持在一次请求中生成多张图像,并保持风格和内容一致。
在实际应用中,这意味着可以完成:
- 系列海报
- 漫画分镜
- UI 方案对比
官方信息显示,模型可以在一次请求中生成最多 8 张图像,并保持角色与视觉一致性。
4. 引入思考能力
Images 2.0 首次引入推理机制,可以在生成前进行结构分析,并在需要时调用外部信息。
这种能力的作用体现在两个方面:
一是生成结果更符合逻辑
二是复杂任务中错误率明显降低
部分模式下,模型甚至可以联网获取信息并对结果进行校验,从而提升准确性 。
5. 更接近设计流程的输出方式
这一代模型不再只是输出图片,而是更接近设计稿。
在测试中可以发现:
- 自动控制留白与布局
- 提供更完整的信息结构
- 输出具有视觉层级
这一变化使它从图像工具,逐渐转向视觉生产工具。
二、ChatGPT Images 2.0 与同类模型对比
从目前的能力结构来看,它已经和传统图像模型形成明显差异。
| 模型 | 核心能力 | 文本能力 | 多图一致性 | 控制能力 | 适合场景 |
|---|---|---|---|---|---|
| ChatGPT Images 2.0 | 设计级生成 | 强 | 强 | 强 | 海报、UI、信息图 |
| Midjourney | 艺术生成 | 弱 | 弱 | 中 | 风格图像 |
| Stable Diffusion | 可控生成 | 中 | 弱 | 强 | 本地生成 |
| DALL·E(旧版) | 基础生成 | 中 | 弱 | 中 | 通用图像 |
整体来看,Images 2.0 的优势不在风格,而在可用性。
三、如何免费使用 ChatGPT Images 2.0
目前使用门槛并不高,普通用户也可以体验。
1. ChatGPT 直接使用
入口如下:
登录之后选择支持图像的模型即可使用。
根据官方信息,该能力已经逐步向所有用户开放,不同订阅等级在调用次数和能力上会有所区别 。
2. 使用 Thinking 或 Pro 模式
在更高配置模式下,模型能力会进一步提升。
主要体现在:
- 支持多图生成
- 支持联网信息
- 提供更高一致性
适合需要高质量输出的场景。
3. API 调用方式
开发者可以通过 API 使用该能力:
👉 https://platform.openai.com/docs
对应模型:
gpt-image-2
适用于:
- 产品集成
- 自动化内容生成
- 图像工具开发
四、实际使用流程
为了更接近真实使用,这里用一个典型场景说明。
假设需要制作一张品牌海报。
1. 初始生成
可以直接输入完整需求,例如:
生成一个咖啡品牌宣传海报,中文文案,现代极简风格,横版比例
模型会自动完成:
- 文案生成
- 排版设计
- 视觉风格匹配
2. 二次优化
在生成基础上继续调整,例如:
优化字体风格,提升品牌质感
模型会基于已有结构进行优化,而不是重新生成。
3. 多版本输出
如果需要对比方案,可以要求生成多张:
生成三种不同设计风格版本
这一阶段可以直接完成设计选型。
五、使用中的关键建议
在实际使用中,有几个点比较关键。
1. 使用自然语言描述
这一代模型对自然语言理解能力更强,不需要刻意堆叠关键词。
描述越接近真实需求,效果越稳定。
2. 分阶段优化结果
复杂图像建议分多轮完成,而不是一次生成。
这样可以逐步控制结果,提高质量。
3. 注意信息类图像校验
在涉及结构说明或流程图时,仍建议进行人工校对。
目前模型在极复杂结构表达上仍存在一定误差。
六、真实体验感受
从实际使用来看,这一代最大的变化不是画得更好,而是更接近真实设计流程。
它能够在生成图像的同时,参与信息组织与视觉表达。
在以下场景中提升尤其明显:
- 信息图制作
- UI 原型设计
- 内容营销图
这种变化意味着图像生成开始进入实际生产阶段。
七、资源入口汇总
ChatGPT
👉 https://chat.openai.com
官方博客
👉 https://openai.com/index/introducing-chatgpt-images-2-0/
API 文档
👉 https://platform.openai.com/docs
写在最后
如果说过去的图像模型解决的是生成问题,那么这一代开始解决表达问题。
模型不再只是输出图像,而是在帮助用户完成从想法到视觉结果的过程。
这也是为什么很多人用过之后,会感觉它更像一个参与创作的工具,而不是单纯的生成器。