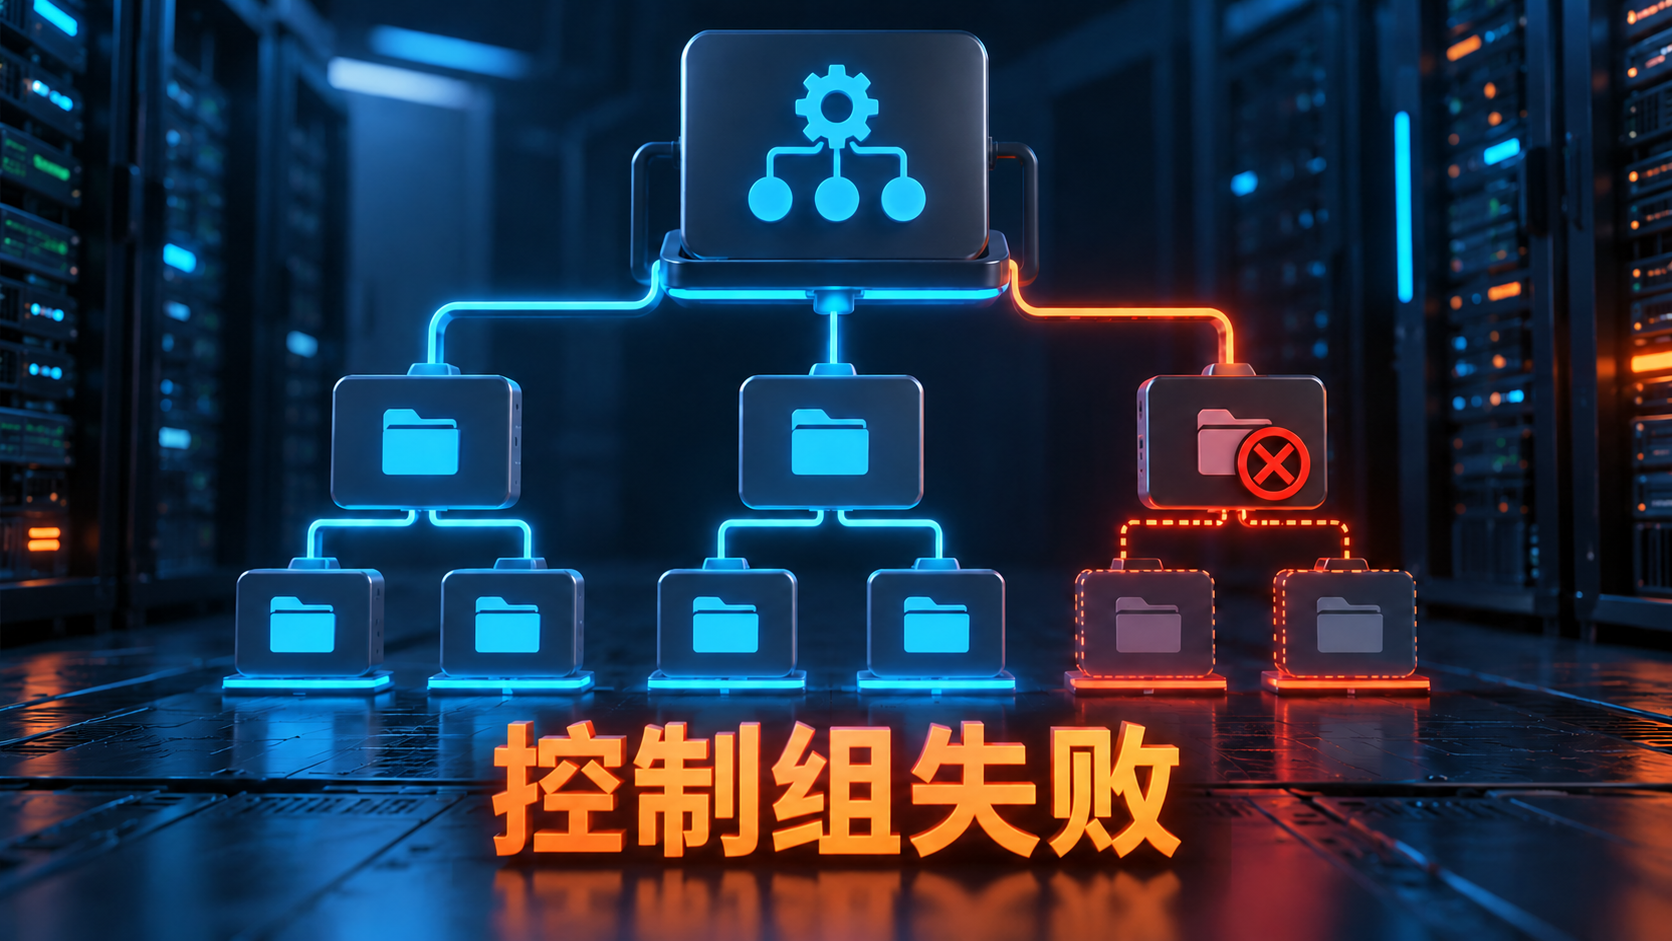
systemd服务启动失败并显示 status=219/CGROUP,表示服务程序执行前,systemd没有成功建立或配置该服务的控制组。此时应用本身往往还没有真正启动。
先检查cgroup层级、挂载状态和单元资源控制项,不要把问题当成ExecStart命令错误。
先确认失败码与启动阶段
收集状态和本次启动日志:
systemctl status example.service --no-pager -l
journalctl -u example.service -b --no-pager -n 100
systemctl show example.service -p Result -p ExecMainCode -p ExecMainStatus219/CGROUP对应控制组设置失败,与203/EXEC、217/USER等状态含义不同。只有日志同时出现219或cgroup错误时,才沿本文方向处理。
查看最终生效的单元配置
读取主单元和全部drop-in:
systemctl cat example.service
systemctl show example.service -p Slice -p Delegate -p CPUWeight -p MemoryMax -p TasksMax
systemd-analyze verify example.service
重点检查 Slice=、Delegate=、MemoryMax=、CPUWeight= 和 TasksMax=。拼写正确不代表运行环境支持,最终属性比只查看某个文件更可靠。
检查cgroup挂载与systemd状态
执行:
findmnt -t cgroup,cgroup2
stat -fc %T /sys/fs/cgroup
systemctl is-system-running
systemd-detect-virt
cgroup v2一般显示 cgroup2fs。若 /sys/fs/cgroup 未挂载、只读、层级损坏或PID 1并非完整systemd,服务控制组就可能无法建立。
容器和嵌套虚拟化要单独判断
在容器内运行systemd,需要运行时正确提供cgroup命名空间和挂载。仅把 /sys/fs/cgroup 任意绑定为可写,可能破坏宿主机资源隔离。
不要在生产宿主机上用chmod或随意重挂载cgroup目录。 应从容器启动参数、运行时版本和宿主机systemd配置修正边界;受限容器无法获得所需控制权时,应把服务交给容器运行时管理。
核对Slice与资源控制项
自定义 Slice= 必须指向能够被systemd正确管理的层级。先检查:
systemctl status custom.slice
systemctl show custom.slice -p LoadState -p ActiveState临时注释最近新增的资源控制项,可以帮助确认兼容性,但应保留变更记录。不要一次删除全部沙箱和资源限制,否则会掩盖真正的冲突并降低隔离强度。
用drop-in做最小修正
使用:
systemctl edit example.service只覆盖确认有问题的项,例如恢复默认Slice:
[Service]
Slice=system.slice
保存后执行 systemctl daemon-reload 并重启服务。需要复现不同cgroup版本时,可使用 萤光云 或 LightNode 建立隔离测试机。调整前先保存原drop-in,确认问题后再固化。
修复后怎样验收
重新启动并核对服务所在控制组:
systemctl restart example.service
systemctl status example.service --no-pager
systemctl show example.service -p ControlGroup -p Result
systemd-cgls --unit example.service验收标准是Result为success、ControlGroup路径存在、进程位于预期Slice内,重启后不再出现219/CGROUP。
FAQ
219/CGROUP是程序自己的退出码吗? 多数情况下不是,它由systemd在执行程序前的控制组准备阶段返回。
升级内核后出现该错误怎么办? 应同时核对systemd版本、cgroup模式、启动参数和容器运行时,不能只回滚应用。
温馨提示
cgroup关系到整机资源隔离。任何重挂载、委派或Slice调整都应先在测试环境验证,并保留可回退配置。