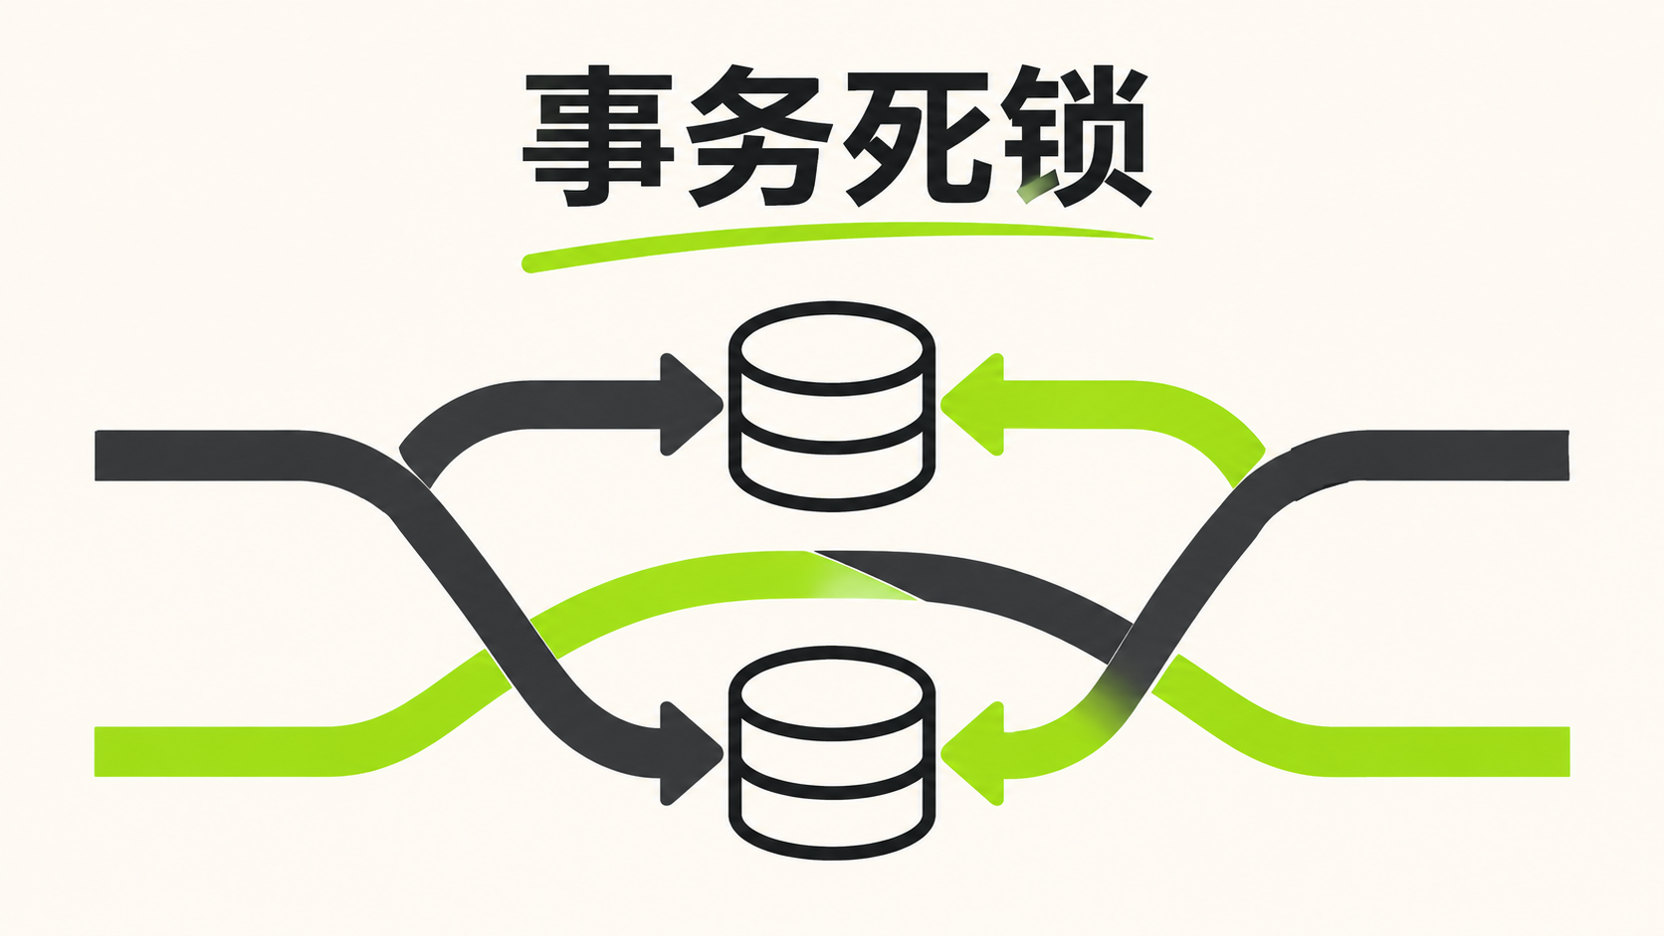
两个请求各自执行成功,碰在一起却有一个报1213。对InnoDB来说,被选中回滚的是事务;只把最后一条SQL再发一次,可能把本来应一起完成的更新拆开。
先区分死锁与等待超时
在驱动里核对MySQL错误号1213与SQLSTATE 40001。不要把1205锁等待超时按同一种回滚范围处理;InnoDB锁等待超时默认回滚当前语句,配置可能改变这一行为。
抓取锁顺序证据
在有权限的运维会话执行SHOW ENGINE INNODB STATUS;,查看LATEST DETECTED DEADLOCK,核对两边涉及的索引、语句与等待对象。这是最近一次记录,可能被后续事件覆盖;只在受控环境分享脱敏结果。
在事务边界重试
捕获明确的死锁错误后,让驱动或ORM清理事务上下文,再从事务起点重新读取、计算并写入;设置有限次数和带抖动的短退避。只重放完整且可重试的业务单元,达到上限应记录并返回失败。连接中断且提交结果未知时,不能照搬此逻辑。
减少两个事务拿锁的交叉
对涉及同一组记录的路径统一访问顺序,例如都按主键升序;缩短事务、让查询使用合适索引,并用执行计划确认扫描范围。外部付款、通知和HTTP调用不可直接跟着数据库事务盲目重放。按业务使用幂等键或提交后可靠投递。
验收要检查业务只生效一次
在萤光云或LightNode的隔离实例用两条连接和测试数据复核重试、回滚和次数上限。验收看余额、库存或订单状态是否正确,同时观察1213频率及重试后失败率,不以一次请求返回成功为准。
FAQ
重启数据库能治好吗? 不能解决应用锁顺序。
只重试失败SQL行不行? 1213下应回到事务起点。
增加等待时间有用吗? 等待超时设置不是修复死锁的手段。
所有失败都该重试吗? 仅重试已分类且业务可安全重放的错误。
改成同一顺序能消灭所有死锁吗? 不能保证,还需检查索引、其他路径和外键等因素。
温馨提示
不要为排障临时关闭事务保护。先在小范围发布并监测重试率,避免并发重试进一步推高负载。